
双环境训练
双环境训练使用两组数据分别学习两套世界模型,再让策略在另一套模型中接受验证。它适合检查策略是否过度依赖某个世界模型的预测特点。本页以倒立摆为例,说明数据准备、配置、报告阅读和模型选择。
使用场景与工作原理
在世界模型中训练策略时,策略可能逐渐找到模型预测偏乐观的状态或动作。例如,机器人在模型中获得很高的前进奖励,换到另一套模型后优势却消失。此时值得检查策略是否利用了模型误差。
双环境提供一个交叉检查方法:用数据 A 训练环境 A,用数据 B 训练环境 B;策略 A 在环境 A 中学习,再用环境 B 和数据 B 的起点选模。完整模式还训练策略 B,方向相反。
| 您遇到的需求 | 双环境可以提供的检查 | 后续业务判断 |
|---|---|---|
| 模型内奖励持续上升,但实际效果不稳定 | 比较同一策略在两套动力学模型中的表现 | 用独立仿真或设备数据检查预测与控制效果 |
| 两组运行轨迹覆盖的工况不同 | 分别观察环境差异和起点分布差异 | 补充覆盖不足的工况,而非只比较总平均值 |
| 需要更稳妥地选取策略训练轮次 | 用另一环境的指标选择检查点 | 核对约束、误差和业务收益 |
以倒立摆为例,两套世界模型都学习姿态、角速度和力矩之间的关系。若某个策略只在环境 A 中容易保持直立,而在 B 中大幅摆动,就应检查模型误差、动作范围和训练数据覆盖。两套环境表现接近,也仍需通过 Gym 仿真检验。
选择一套或两套策略
| 设置 | 世界模型数 | 策略数 | 使用建议 |
|---|---|---|---|
| 关闭插件 | 1 | 1 | 建立单环境基线、日常迭代 |
policy_mode: single | 2 | 1 | 先检查策略 A 在另一环境上的表现 |
policy_mode: dual | 2 | 2 | 同时观察两侧策略与环境的差异 |
支持 venv.bc、venv.revive_p、policy.ppo 和 policy.sac。ADM2、控制器、环境集成及整套双分支断点续训暂不支持。policy_mode 决定模型数量,执行串行或并行由 execution.mode 单独决定。
flowchart TD
    D["按轨迹切分数据 A / B"] --> A["环境 A:A 训练,B 选模"]
    D --> B["环境 B:B 训练,A 选模"]
    A --> P["环境对完成后训练策略"]
    B --> P
    P --> PA["策略 A:环境 A 训练,环境 B 选模"]
    P --> PB["策略 B:环境 B 训练,环境 A 选模"]
    PA --> O["检查结果,默认部署选中的 A"]
    PB --> O
准备数据与配置
分配训练数据
插件沿用一次 data.train_ratio / data.split_seed 切分,之后交换两侧角色:
| 对象 | 训练来源 | 选模来源 |
|---|---|---|
| 世界模型 A | 数据 A | 数据 B |
| 世界模型 B | 数据 B | 数据 A |
| 策略 A | 环境 A、起点 A | 环境 B、起点 B |
| 策略 B | 环境 B、起点 B | 环境 A、起点 A |
两侧都需要足够数据。按完整轨迹切分能减少相邻样本混入两侧的问题。seed_offset 默认 100000,仅偏移 B 的训练随机流,不改变切分;两侧模型、优化器和缓存独立,归一化采用 all_visible_data 设置。
如果提供 data.val_path,该文件会用于训练 B,需要显式设置 allow_validation_training: true。因此 A/B 都参与训练与模型选择,独立业务测试应另行保留。data.paired_split_role 在此流程中保持为空。
在已有项目中启用
在 training 中加入以下片段,保留原有图、数据、奖励与阶段配置:
training:
  plugins:
    dual_environment:
      enabled: true
      policy_mode: dual
      validation:
        full_matrix: true
        seed: 42
        diagnostic_interval: 1
参与的策略阶段显式设置 inherit_from: <世界模型阶段名>。只对部分阶段启用时,在插件中设置 stages: [venv, policy],填写实际阶段名。
full_matrix 控制是否评估完整组合;diagnostic_interval: 1 在每次阶段验证时补齐矩阵,便于观察奖励曲线。默认值 0 减少过程中的额外评估,在阶段末对选中模型补评。关闭功能时设 enabled: false。
示例训练与设备选择
运行倒立摆示例
先完成倒立摆的数据准备。在仓库根目录执行,若目标配置已存在则换一个文件名:
cd examples/pendulum
cp config.min.yaml config.dual.yaml
保留复制文件中的图定义,将 training 替换为:
training:
  device: cpu
  plugins:
    dual_environment:
      enabled: true
      validation:
        diagnostic_interval: 1
  stages:
    - name: venv
      algorithm: venv.bc
    - name: policy
      algorithm: policy.ppo
      inherit_from: venv
      hyperparameters:
        reward: {path: reward.py, function: get_reward}
仍在 examples/pendulum 目录中,先检查并执行短训练:
revive validate --config config.dual.yaml --train-data data/pendulum.npz --profile smoke
revive train --config config.dual.yaml --train-data data/pendulum.npz \
  --log-dir logs --run-id pendulum-dual-smoke --seed 13 --profile smoke
查看 logs/pendulum-dual-smoke/report.md,进入世界模型和策略阶段的双环境报告。默认模型保存到该 run 的 models/env.pt 与 models/policy.pt。正式比较时按任务设置训练规模,去掉 --profile smoke,使用新的 run ID。
单卡、双卡与 CPU
一张卡即可完成双环境训练:A/B 依次使用 training.device。默认 execution.mode: auto 根据本任务分配的设备和 CPU 额度选择执行方式。
| 分配资源 | auto 的执行方式 |
|---|---|
| 一张 CUDA/NPU 卡 | 单卡串行 |
| 两张不同设备且 CPU 额度足够 | A/B 各用一张卡并行 |
| CPU 足够两个分支 | 两进程并行 |
| 资源只够一个分支 | 串行 |
单卡只需在上面的配置中将 training.device 改为 cuda:0。双卡在插件下增加:
execution:
  mode: auto
  cpu_per_branch: 1
  devices: [cuda:0, cuda:1]
设备对第一项应与 training.device 相同,设备编号相对于当前可见设备集合。显式 serial 始终串行;显式 parallel 要求双分支资源齐全,不满足时会在预检中报错。
每分支所需 CPU 为 cpu_per_branch + data.num_workers。例如每分支 2 个线程、1 个 DataLoader worker,两个分支并行至少需要 6 核。实际模式、设备与原因见阶段目录的 dual_environment/execution.json,资源记录见各分支的 artifacts/resources.json。
阅读报告与选择模型
先看选中的模型
默认部署模型来自 A 分支按交叉指标选中的最佳检查点。B 用于对称比较,不会因某个奖励更高就自动替换 A。
| 文件 | 阅读目的 |
|---|---|
dual_environment/report.html | 查看交叉矩阵、奖励曲线与选模结果 |
dual_environment/report.json | 核对指标、起点、阶段和选中模型 |
dual_environment/metrics.csv | 比较各轮训练验证与选中模型复评 |
dual_environment/quality.json | 查看已配置质量规则的结果 |
environment_pair.json | 确认世界模型 A/B 的配对关系 |
比较奖励曲线
策略阶段的 double_validation.png 使用四个子图:列表示起点来自 A 或 B,行表示环境 A 或 B。红线为策略 A,绿线为策略 B;星号为选中模型的评估值,竖线标记其最佳 Epoch。
纵轴为未折扣平均单步奖励 val/rollout/reward_mean。蓝色虚线使用同一奖励函数计算对应数据分区的日志基线:日志按有效步等权平均,策略先在每条 rollout 内平均,再对 rollout 平均。比较时同时关注回合长度与起点分布。
读图顺序
- 固定同一列、同一策略和 Epoch,上下比较两套环境,观察动力学差异。
- 在同一子图、同一 Epoch 比较红绿曲线,观察策略差异。
- 固定同一环境和策略,左右比较起点分布的影响。
- 回到交叉选模指标确认部署候选;策略 A 用环境 B、起点 B 选模,策略 B 方向相反。
完整曲线需要 full_matrix: true、正的 diagnostic_interval,以及策略阶段启用 rollout 验证。采样轮次同时满足阶段验证间隔和诊断间隔。缺失格显示 not evaluated;采样点不足时无法判断训练趋势。
倒立摆结果示例
下面的倒立摆配置训练 16 个策略 Epoch(0~15),每条曲线包含 16 个验证点,用于说明如何区分环境差异与起点差异。
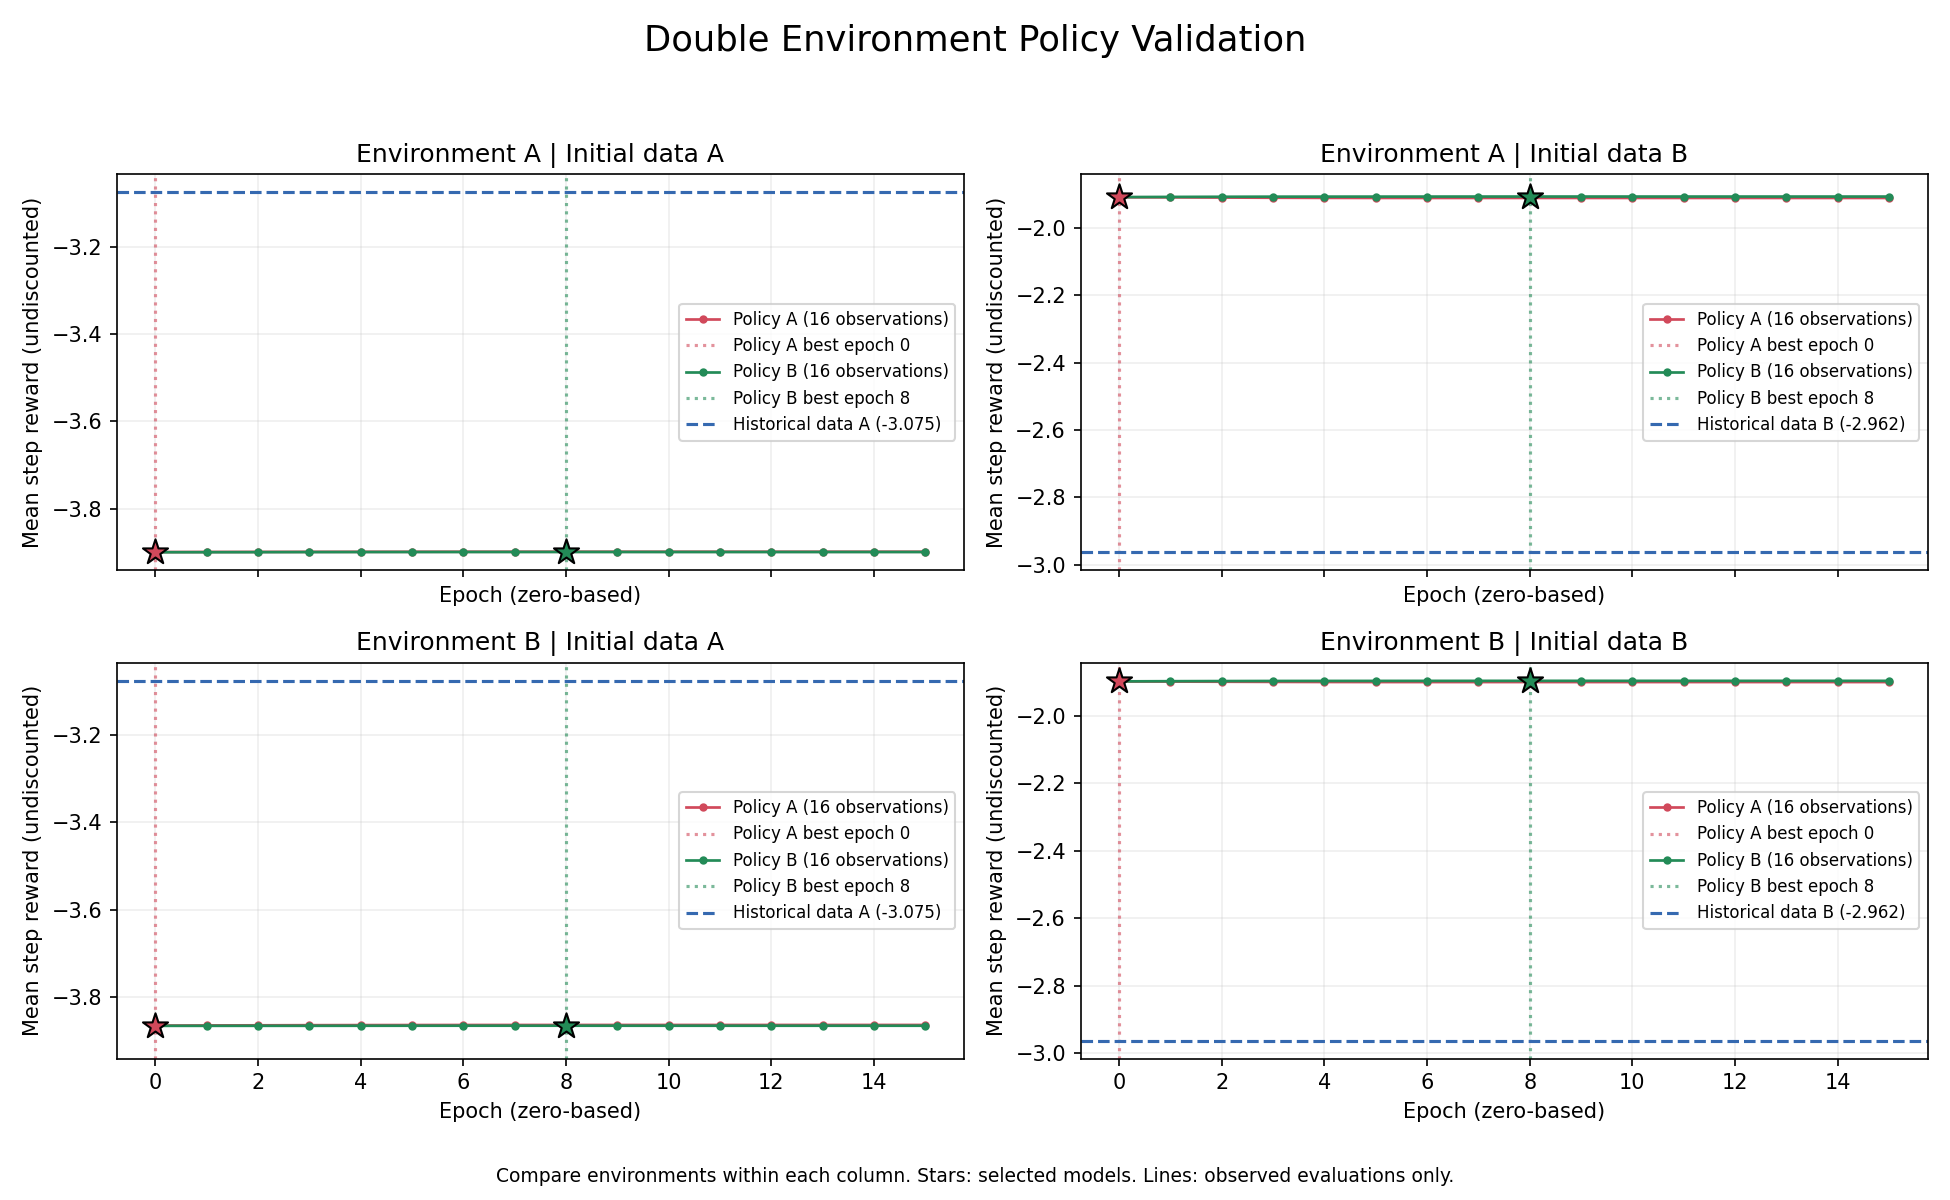
策略 A 选中模型(Epoch 0)的平均单步奖励为:
| 初始数据 | 环境 A | 环境 B | 数据基线 |
|---|---|---|---|
| A | −3.8997 | −3.8657 | −3.0753 |
| B | −1.9099 | −1.8976 | −2.9624 |
同一起点下环境差约为 0.0340 和 0.0122,更换起点分区后则相差约 1.99 和 1.97。此时应优先检查初态与工况覆盖。起点 A 的两项结果低于对应基线,起点 B 的结果高于基线,应分别报告。
曲线在 16 个点内的变化范围约为 0.0003~0.0021,奖励没有明显持续改善。两侧最佳 Epoch 分别为 0 和 8,后续应结合训练指标、动作变化和 Gym 仿真结果判断效果。最佳检查点的复评在 CSV 中标为 phase=selected_checkpoint,查看训练趋势时使用 phase=training。
常见走势
| 现象 | 下一步检查 |
|---|---|
| 训练环境改善,另一环境下降 | 检查动作是否离开数据范围、世界模型的多步预测误差 |
| 两套环境中策略排名翻转 | 查看访问的状态与动作,用独立环境检验策略 |
| 两环境接近,但两个起点分区差异大 | 检查初态、工况覆盖与抽样条件 |
| 曲线接近平直或只出现单点尖峰 | 查看实际数值、优化器步数及奖励分项,再安排重复评估 |
双环境差距需结合奖励量纲与业务容忍度解释。多个 Epoch 不等于多次独立实验;细小差异应在固定评估条件下通过多 seed 检查。
设置质量规则与复用模型
配置质量要求
可根据业务的预测误差、最低回报和环境差异设置质量规则。以下数值仅演示格式,需按项目量纲调整:
training:
  plugins:
    dual_environment:
      enabled: true
      quality_rules:
        - domain: venv
          metric: val/rollout/mae
          maximum: 0.5
        - domain: policy
          metric: val/rollout/return_mean
          minimum: -1500
          max_environment_gap: 300
minimum / maximum 检查交叉验证结果;max_environment_gap 比较同一起点、同一随机条件下两环境的指标差,需要 full_matrix: true。指标缺失或超限会使规则不通过,具体结果见 quality.json。未配置规则时记录 not_configured。
世界模型质量通过后才进入策略阶段,策略通过后发布默认部署模型。两套模型也可能共享偏差,业务测试仍应使用另行保留的数据或独立仿真。
复用已训练的环境对
可以先运行世界模型阶段,再在同一 run 中运行策略阶段。策略也可通过 env_record_id 引用已完成的双环境根记录,替代 inherit_from,并保持数据及切分身份一致。
复用时保留根记录、branches/A、branches/B 和配对清单。单独复制默认 env.pt 只提供一个模型,不能代替环境对。策略超参搜索使用固定的环境对,使不同 trial 的奖励可比。
A/B 按默认 output.checkpoint_policy: best_only 各自保留最佳权重及同轮训练状态。整套双环境流程目前不支持精确续训;改变配置或修复失败后使用新的 run。输出配置见设置训练流程。
常见问题
| 现象 | 处理方法 |
|---|---|
| 两张卡可见但仍串行 | 在 execution.devices 明确分配不同设备,并核对 CPU 额度 |
单卡使用 parallel 报错 | 使用 auto 或 serial |
| 策略阶段没有 B 目录 | 检查 policy_mode 是否为 single |
| 复制模型后无法复用双环境 | 提供完整根记录、两侧模型与配对清单 |
| 奖励曲线只有少量点 | 核对 rollout 验证间隔、full_matrix 和 diagnostic_interval |
| OOM 或某分支失败 | 查看分支日志及 execution.json,调整资源后创建新 run |
--resume 被拒绝 | 双环境流程不支持通过单分支检查点恢复 |
完整模式增加一套世界模型和策略的训练成本,矩阵评估也会增加耗时。先完成单环境基线,再按相同数据划分与评估条件比较效果和资源使用。进一步阅读评估与选择模型及自动搜索参数。