
机器人控制
本例使用 HalfCheetah 运动数据训练机器人世界模型,再训练 SAC 策略协调六个关节,兼顾前进速度与动作开销。最后在 MuJoCo 环境中评估机器人运动效果。
1. 任务背景与目标
关节协调如何产生向前运动
HalfCheetah 是 Gym/MuJoCo 中的平面机器人运动任务。机器人由躯干与前后两组关节链组成,六个关节分别接受连续控制指令。关节力矩通过足端与地面的接触转化为躯干运动,因此单个关节动作的效果取决于其他关节的位置、速度和接触状态。
控制难点在于协调:持续使用最大力矩会增加动作代价,也可能打乱运动节律;只追求某一步位移又容易产生后续失稳。策略需要在多个时间步内协调关节,使机器人持续向前运动。
17 维观测描述躯干高度、姿态、关节位置及运动速度。观测不包含用于直接计算前向位移的绝对水平位置,因此建模时额外学习每步位移 delta_x。它连接了机器人动力学和奖励计算,是除状态误差之外需要重点检查的预测量。
状态、动作与奖励
HalfCheetah 来自 Gym 的 MuJoCo 控制环境。本任务控制机器人的 6 维关节动作,在动作开销与前进速度之间取得较高回报。 本例使用 D4RL medium 已有交互记录学习世界模型,再在模型中训练 SAC, 固定候选后才进入独立 MuJoCo 仿真。训练不需要取得日志采集时的控制器。
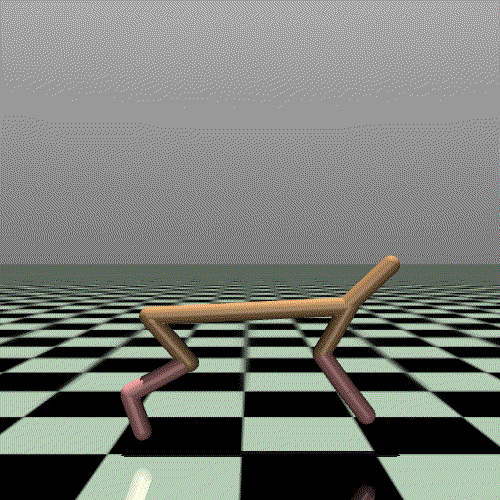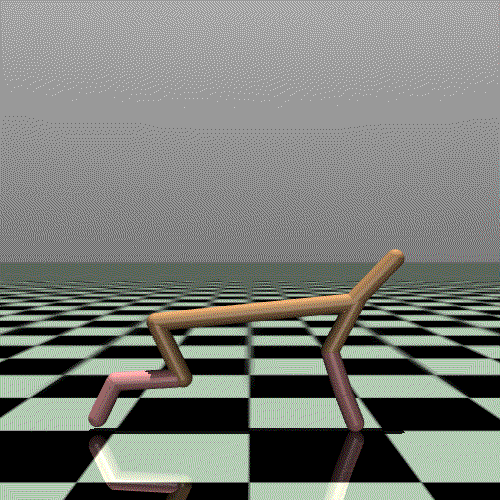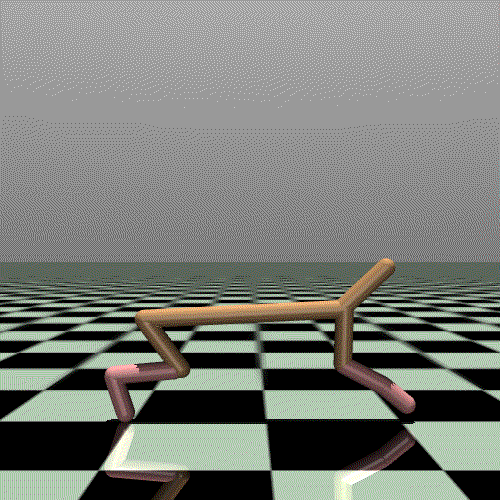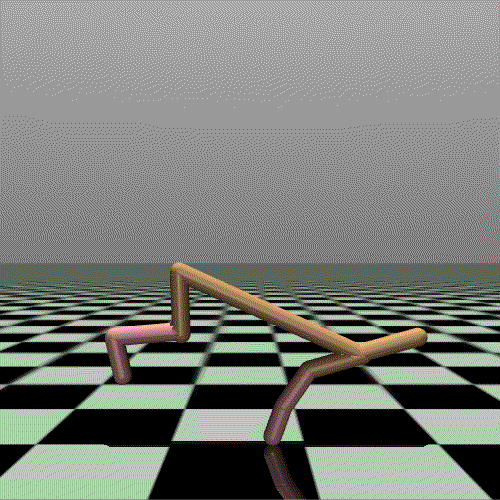
图:HalfCheetah 机器人控制环境。
观测 obs 为 17 维,动作 action 为 6 维,每维边界 [-1, 1]。 examples/halfcheetah/reward.py使用前向位移与当前动作计算奖励:
reward = delta_x / 0.05 - 0.1 × sum(action²)delta_x 是模型单独预测的前向位移;因此它的乐观偏差可能直接抬高模型内收益。 状态预测 MAE 小不等于奖励建模准确,更不自动意味着新策略超越原日志。
2. 数据与准备
六个关节动作要与同一时刻的 17 维观测对齐。世界模型既要预测下一状态,也要预测决定前进奖励的位移;因此准备数据时保留动作、前后状态和奖励,并利用已知奖励公式构造 delta_x 标签。
完整入口使用 data/halfcheetah-medium-1000traj.npz,标准数据约百万条转移。 实际记录数与轨迹长度应以 NPZ 的 index 为准,不从文件名推断等长轨迹。
| 字段 | 形状 | 含义 |
|---|---|---|
obs | [N, 17] | 当前观测 |
next_obs | [N, 17] | 显式下一步标签,不需要 loader 再派生 |
action | [N, 6] | 已执行的连续动作 |
delta_x | [N, 1] | 根据已存奖励和动作反推的位移标签 |
reward | [N, 1] | 已存环境奖励 |
done | [N, 1] | 原始 terminals;转换脚本保留为 float64 |
index | [K] | 轨迹右开结束下标,int64 |
其余连续数组转换为 float32。位移标签按 delta_x = (reward + 0.1 * sum(action²)) * 0.05 构造; 它不是可以在执行动作前获得的实测输入。模型推演时必须自己预测该节点。
获取与复用
准备 D4RL halfcheetah-medium-v2 数据。已有转换文件时,将 halfcheetah-medium-1000traj.npz 放入本例 data/ 目录;使用 HDF5 原料时,将 halfcheetah_medium-v2.hdf5 放入同一目录,或用 REVIVE_HALFCHEETAH_HDF5 指定路径。原始 D4RL 数据单独准备,不随 SDK 安装包分发;转换脚本在本地读取 HDF5,不会自动下载数据。
后续命令均在案例目录执行:
cd examples/halfcheetah
python prepare_data.py --fullexamples/halfcheetah/prepare_data.py若发现目标包含全部必要字段就直接复用,不需要 HDF5。 这个检查只核对字段是否存在,不验证数据维度或奖励一致性;这些应另行核验。 脚本顶层使用 h5py、NumPy,即使复用 NPZ 也需要相应 Python 依赖。
| 准备参数 | 目标文件 | 范围 |
|---|---|---|
| 无规模参数 | data/halfcheetah-medium-200traj.npz | 前 200 条 |
--smoke | data/halfcheetah-medium-10traj-smoke.npz | 前 10 条 |
--full | data/halfcheetah-medium-1000traj.npz | 最多 1000 条,完整训练入口 |
需要重建时,脚本读取本地 data/halfcheetah_medium-v2.hdf5,或从候选目录复制; 外部源文件可由 REVIVE_HALFCHEETAH_HDF5 指定。它不会联网下载 HDF5,更不会仿真采集。 --force 重写 NPZ;--refresh-hdf5 控制复制原料,但在有效 NPZ 被直接复用时不会执行复制。 应明确备份和重建目的后再使用覆盖参数。
轨迹边界沿用转换脚本对相邻 next_obs 与 obs 差值之和是否为零的判断, 不是简单按 done 或每 1000 行切分。换用自己的原料时必须检查该边界算法是否适用, 尤其注意浮点误差、差值抵消和截断记录。
日志行为策略基线
两个评估脚本都没有 --dataset 模式。只统计已有日志时, 可在案例目录的 Python 会话执行以下代码,无需导入仿真环境:
import numpy as np

with np.load("data/halfcheetah-medium-1000traj.npz", allow_pickle=False) as data:
    reward = data["reward"].reshape(-1)
    ends = data["index"].reshape(-1).astype(np.int64)
    starts = np.concatenate(([0], ends[:-1]))
    returns = np.array([reward[s:e].sum() for s, e in zip(starts, ends)])
    lengths = ends - starts
print("episodes:", len(returns), "length range:", lengths.min(), lengths.max())
print("return mean/std:", returns.mean(), returns.std())
先核对日志与仿真回合长度,再比较总回报。该基线是原工况下的历史统计, 不是在相同初态重跑原专家的配对对照。
3. 建模与配置
下面先展示 examples/halfcheetah/config.yaml 的配置,再结合本任务逐块解释。训练命令使用同一文件。
name: halfcheetah
version: '1.0'
graph:
  nodes:
    action:
      inputs: [obs]
      network:
        backbone: mlp
        hidden_dims: [256, 256, 256]
        activation: leakyrelu
      output_dist: DiagonalNormal
      dist_config: {min_std: 0.001, max_std: 0.5}
    delta_x:
      inputs: [obs, action]
      network:
        backbone: mlp
        hidden_dims: [256, 256, 256]
        activation: leakyrelu
      output_dist: DiagonalNormal
      dist_config: {min_std: 0.001, max_std: 0.5}
    delta_obs:
      inputs: [obs, action, delta_x]
      network:
        backbone: res
        hidden_dims: [256, 256, 256, 256]
        activation: leakyrelu
      output_dist: DiagonalNormal
      dist_config: {min_std: 0.001, max_std: 0.5}
    next_obs:
      inputs: [obs, delta_obs]
      function: builtin.delta_add
  transitions: auto
  columns:
  - {name: obs_0, node: obs, type: continuous}
  - {name: obs_1, node: obs, type: continuous}
  - {name: obs_2, node: obs, type: continuous}
  - {name: obs_3, node: obs, type: continuous}
  - {name: obs_4, node: obs, type: continuous}
  - {name: obs_5, node: obs, type: continuous}
  - {name: obs_6, node: obs, type: continuous}
  - {name: obs_7, node: obs, type: continuous}
  - {name: obs_8, node: obs, type: continuous}
  - {name: obs_9, node: obs, type: continuous}
  - {name: obs_10, node: obs, type: continuous}
  - {name: obs_11, node: obs, type: continuous}
  - {name: obs_12, node: obs, type: continuous}
  - {name: obs_13, node: obs, type: continuous}
  - {name: obs_14, node: obs, type: continuous}
  - {name: obs_15, node: obs, type: continuous}
  - {name: obs_16, node: obs, type: continuous}
  - {name: action_0, node: action, type: continuous, min: -1.0, max: 1.0}
  - {name: action_1, node: action, type: continuous, min: -1.0, max: 1.0}
  - {name: action_2, node: action, type: continuous, min: -1.0, max: 1.0}
  - {name: action_3, node: action, type: continuous, min: -1.0, max: 1.0}
  - {name: action_4, node: action, type: continuous, min: -1.0, max: 1.0}
  - {name: action_5, node: action, type: continuous, min: -1.0, max: 1.0}
  - {name: delta_x, node: delta_x, type: continuous, min: -1, max: 1}
data: {train_ratio: 0.5, batch_size: 1024}
training:
  device: auto
  stages:
  - name: venv
    algorithm: venv.revive_p
    hyperparameters:
      epochs: 1000
      bc:
        optimizer: {lr: 0.001, weight_decay: 0.0001, scheduler: none}
        grad_clip: 50
        loss: nll
      adversarial:
        start_epoch: 0
        rollout: {horizon: 20, batch_size: 1024, random_segment_sampling: legacy_replacement, node_clip: 1.5}
    validation:
      selection: {metric: val/rollout/mae}
      one_step: {horizon: 20, max_batches: 128}
      rollout: {enabled: true, horizon: 20, interval: 50, node_clip: 1.0}
  - name: policy
    algorithm: policy.sac
    inherit_from: venv
    hyperparameters:
      gamma: 0.99
      tau: 0.01
      alpha: 0.2
      auto_alpha: false
      actor_lr: 0.001
      critic_lr: 0.001
      alpha_lr: 0.001
      batch_size: 1024
      buffer_size: 1000000
      warmup_steps: 1000
      rollout_length: 10
      validation_horizon: 50
      eval_gamma: 1.0
      updates_per_step: 20
      num_rollout_trajs: 1024
      segment_sampling_mode: segment_uniform
      q_hidden_dims: [256, 256]
      q_network_type: vectorized
      max_grad_norm: 0.0
      num_q: 4
      generate_deter: 1
      drop_last_rollout_transition: true
      expert_replay_enabled: true
      batch_ratio: 1.0
      critic_pretrain: false
      critic_pretrain_epochs: 0
      revive_update_order: true
      fixed_save_epochs: []
      fixed_checkpoint_dir: fixed_checkpoints
      rollout_clip: true
      bpc_type: none
      bpc_weight: 0.0
      w_kl: 0.25
      behavioral_policy_init: true
      policy_nodes: [action]
      epochs: 1001
      reward: {path: reward.py, function: get_reward}
output:
  save_freq: 100
  tensorboard: true
  plotting: {enabled: false, interval: 100}
  onnx: {required: true}
配置入口
| 配置 | 阶段顺序 | 用途与运行规模 |
|---|---|---|
examples/halfcheetah/config.yaml | venv.revive_p → policy.sac | 完整策略构建入口,1000 + 1001 epoch |
examples/halfcheetah/config.min.yaml | venv.revive_p → policy.sac | 最小任务定义,仍含两个阶段;运行规模和省略参数由默认层补全 |
examples/halfcheetah/config_delta_adm2.yaml | venv.adm2 | 300 epoch 的世界模型对照,不包含策略训练 |
obs ──→ action(6)
obs, action ──→ delta_x(1)
obs, action, delta_x ──→ delta_obs(17)
obs, delta_obs ──→ next_obs(17)     builtin.delta_add
下一时刻:obs ← next_obs
将奖励相关位移单列,可以单独诊断其误差;它仍需要从数据学习,不是物理先验公式。 delta_obs 条件于预测的 delta_x,因此诊断时需要区分误差来源与真实可用输入。
配置逐块讲解
| 配置块 | 当前设置 | 解读 |
|---|---|---|
graph | action/delta_x 为三层 256 MLP;delta_obs 为四层 256 残差网络;分布 DiagonalNormal,std 范围 0.001–0.5 | 保留完整配置方案的容量和分布约束,不据此保证数值稳定或数据外泛化 |
graph.columns | 17 维观测、6 维动作、1 维位移;动作 [-1,1]、delta_x [-1,1] | 固定特征与范围;动作最终还由仿真评估器裁剪 |
data | train_ratio: 0.5、batch_size: 1024 | 其余划分设置读取解析结果;数据路径从命令行传入 |
training.stages[venv] | 1000 epoch,BC NLL、lr 1e-3、weight decay 1e-4;对抗推演 20 步,legacy_replacement 采样 | 在数据轨迹上学习运动响应,并优化多步预测 |
training.stages[venv].validation | rollout 20 步,每 50 epoch;选择 val/rollout/mae | 模型内多步预测选模;不是下面强制日志动作的独立诊断分数 |
training.stages[policy] | SAC 1001 epoch,继承 venv;4 个向量化 Q,rollout_length 10、validation_horizon 50、updates_per_step 20 | 短模型采样与较长验证使用不同窗口,不能直接与整集仿真总回报比较 |
training.stages[policy].hyperparameters | 行为策略初始化、w_kl 0.25、固定 alpha 0.2;末尾固定保存 900/920/940/960/980/1000 检查点 | 固定保存不等于这些检查点都被选中,部署时使用已选输出文件 |
output | 默认 best_only、TensorBoard、关闭绘图、ONNX required | 只保留最优模型及同轮续训态;配置中的 save_freq 仅在 legacy 模式生效;导出成功不证明策略效果 |
SAC 回放比例的实际含义
完整配置有 expert_replay_enabled: true、batch_ratio: 1.0, 但当前 revive/train/trainers/policy/sac_trainer.py按以下方式取常规更新批次:
日志样本数 = int(batch_size × (1 - batch_ratio))
模型样本数 = int(batch_size × batch_ratio)
因此本配置方案的常规批次是日志 0、模型 1024,不是 1:1。 critic_pretrain: false 也未开启仅日志的 critic 预训练分支。 行为初始化、KL 与回放取样是不同机制,不能仅凭专家池已创建就宣称每批混入了日志。 实际运行可核对 sample_real_size、sample_generated_size、sample_real_ratio。
4. 训练与选模
先检查完整配置和已有数据,再启动两阶段训练:
revive validate --config config.yaml --train-data data/halfcheetah-medium-1000traj.npz --show-defaults
revive train --config config.yaml --train-data data/halfcheetah-medium-1000traj.npz \
  --run-id hc_full --log-dir logs --seed 42
首次运行可使用新的 run ID 并加 --profile smoke,确认数据、训练和导出流程正常。 每次训练使用独立 run ID。查看 logs/hc_full/report.md、 config.resolved.yaml 与阶段验证曲线;部署入口为 models/env.pt、 models/policy.pt,不能把 latest checkpoint 默认当成选中输出文件。
examples/halfcheetah/evaluate.py 是独立世界模型诊断 CLI,不只是策略脚本的加载工具:
python evaluate.py --model logs/hc_full/models/env.pt --config config.yaml \
  --data data/halfcheetah-medium-1000traj.npz --horizon 20 --train_ratio 0.5 --seed 42 --device cpu
脚本按轨迹重建验证划分,从轨迹起点喂日志动作,用模型递推下一步状态, 报告 processed 空间的 next_obs_rollout_mae。它会把各轨迹取到共同最短长度, 实际 horizon 不超过该长度减一;划分比例和种子应与要复核的训练一致。 这不调用 MuJoCo,也不衡量新策略闭环控制效果。
可选 --force-delta-x 会进一步喂真实位移标签,帮助隔离状态增量网络误差, 但包含实际部署时未知的信息,只能用作条件诊断,不能作为无泄漏世界模型成绩。
世界模型按验证 MAE 选择;SAC 在继承的同一世界模型内按验证奖励选择。 不同世界模型可能存在不同奖励偏差,不能直接把它们各自的虚拟收益当作公平的跨模型排名。 固定候选后再测试;如果用仿真继续挑选候选,应另外留出最终测试种子。
一键运行
允许完整训练和独立仿真时,可用以下入口替代分步命令:
bash run_all.sh hc_oneclick config.yaml默认 run ID 为 halfcheetah,默认配置 config.yaml,训练 seed 42, 可通过 SEED 环境变量更改训练种子。测试仍固定为 10 集、seed 20260626、CPU、d4rl。 先复用或转换完整数据,再训练,最后分别运行人工可读和 JSON 两次仿真, 后者写入 logs/<run_id>/flagship.json。 这是相同协议的两次执行,不是一次结果的格式转换,也不算两组独立种子实验。 数据缺失且没有 HDF5,或指定后端缺失时,应先解决相应前提。
5. 模型使用与评估
examples/halfcheetah/evaluate_policy.py 才是与 MuJoCo 交互的入口:
python evaluate_policy.py --model logs/hc_full/models/policy.pt --config config.yaml \
  --episodes 10 --seed 20260626 --device cpu --backend d4rl --json
它通过公开策略加载入口推理,裁剪动作到 [-1,1],运行到环境终止。 --config 保留为兼容参数,当前策略加载不靠它重建部署图; 测试不需要训练 NPZ 或原规则控制器。
评估协议
| 参数 | CLI 默认值 | 本教程与一键脚本 |
|---|---|---|
--episodes | 10 | 10 |
--seed | 42 | 20260626 |
--backend | auto | d4rl |
默认设备为可用 CUDA,否则 CPU;本教程明确固定 CPU。 脚本没有 --steps、--max-steps 或 --dataset 参数,回合长度由环境的终止协议决定, 不是由模型训练 horizon 决定。每集尝试使用 seed 加回合序号; d4rl 路径使用旧式 env.seed 并忽略其异常,不能保证任意 Gym 版本种子都实际生效。 测试应记录依赖版本、后端、种子和回合协议。
JSON 包含 backend、episodes、seed、real_return_mean、 real_return_std、real_normalized_score。 回报先按回合求和再跨回合统计;没有输出事故率或逐集长度。 归一化分不是“提升百分比”,也不限制在 0–100。
仿真环境与后端选择
已有 NPZ 的训练和前面的离线诊断不需要这些仿真依赖。 独立测试需事先准备兼容的运行环境:
| 后端 | 脚本创建的环境 | 归一化方式与边界 |
|---|---|---|
d4rl | halfcheetah-medium-v2,旧 Gym / mujoco_py 路径 | 调用环境 get_normalized_score 后乘 100;一键脚本指定此后端 |
gymnasium | HalfCheetah-v4,Gymnasium / MuJoCo 路径 | 使用脚本内参考分手算;需要单独建立比较基线 |
auto | 优先 d4rl,失败后尝试 Gymnasium | 会打印回退原因,并非安装任何依赖;不适合隐藏后端差异的对照 |
显式指定 d4rl 失败时退出,不回退。两套后端的实现和依赖不同, 不能假定读数逐位一致或直接复用另一个后端的验收阈值。 手算参考关系为:
normalized = 100 × (return - (-280.178953)) / (12135.0 - (-280.178953))6. 结果与分析
使用 d4rl 后端评估 10 集,起始 seed 为 20260626,使用 CPU 推理和确定性动作,动作范围为 [-1, 1]。
| 指标 | SAC 控制策略 |
|---|---|
| 平均回报 | 8572.75 |
| 回报标准差 | 86.66 |
| D4RL 归一化分 | 71.31 |
回报由前进速度收益减去关节动作代价组成。平均回报较高且标准差较小,表示策略在这组初始条件下能够持续向前运动,回合间表现接近。D4RL 归一化分用于与同一基准上的策略比较,不是相对数据策略的提升百分比。
分析训练结果时,先检查 delta_x 的预测是否偏高,再检查给定动作序列下的状态误差,最后看独立 MuJoCo 回报。如果模型内奖励上升而仿真回报下降,应重点检查位移预测偏差和策略是否进入数据稀疏区域。
不同候选使用相同后端、环境版本和测试种子。模型内的平均每步奖励与完整仿真回合的总回报分别报告。
7. 迁移到实际业务
保留“已知奖励公式 + 未知状态与奖励相关动力学”的分工,检查关键奖励节点的偏差, 而不只追求高维状态平均误差。固定数据划分和离线选模规则,另外保留独立测试条件; 最后用目标机器人或匹配的仿真环境检验速度、动作代价和运行稳定性。
阅读任务页约定,区分数据准备、训练验证和独立评估。