
分析训练结果
训练结束后,您需要确认三件事:模型是否完成训练、预测或控制效果是否满足目标、哪一份模型可以继续使用。本页以倒立摆和冰箱温控说明报告与指标的读法。调整验证规则见评估与选择模型,需要改善效果时进入改善预测与控制效果。
找到训练结果
在任务目录执行,repro 替换为实际运行名称:
revive report --run logs/repro打开运行目录中的 report.md。命令根据已有训练记录整理报告,重新计算模型效果需要使用相应任务的评估程序。
| 先看什么 | 可以判断什么 |
|---|---|
| 运行名称、任务配置和训练规模 | 是否正在查看目标实验;使用 smoke 的记录用于流程检查 |
| 各阶段状态 | 世界模型、策略或控制器是否完成,哪里发生错误 |
| 选模指标、方向和轮次 | 为什么保留这个候选模型 |
| ONNX 导出与验证结果 | 部署文件是否生成,采用哪种验证方式 |
| 模型路径 | 后续推理应加载哪份文件 |
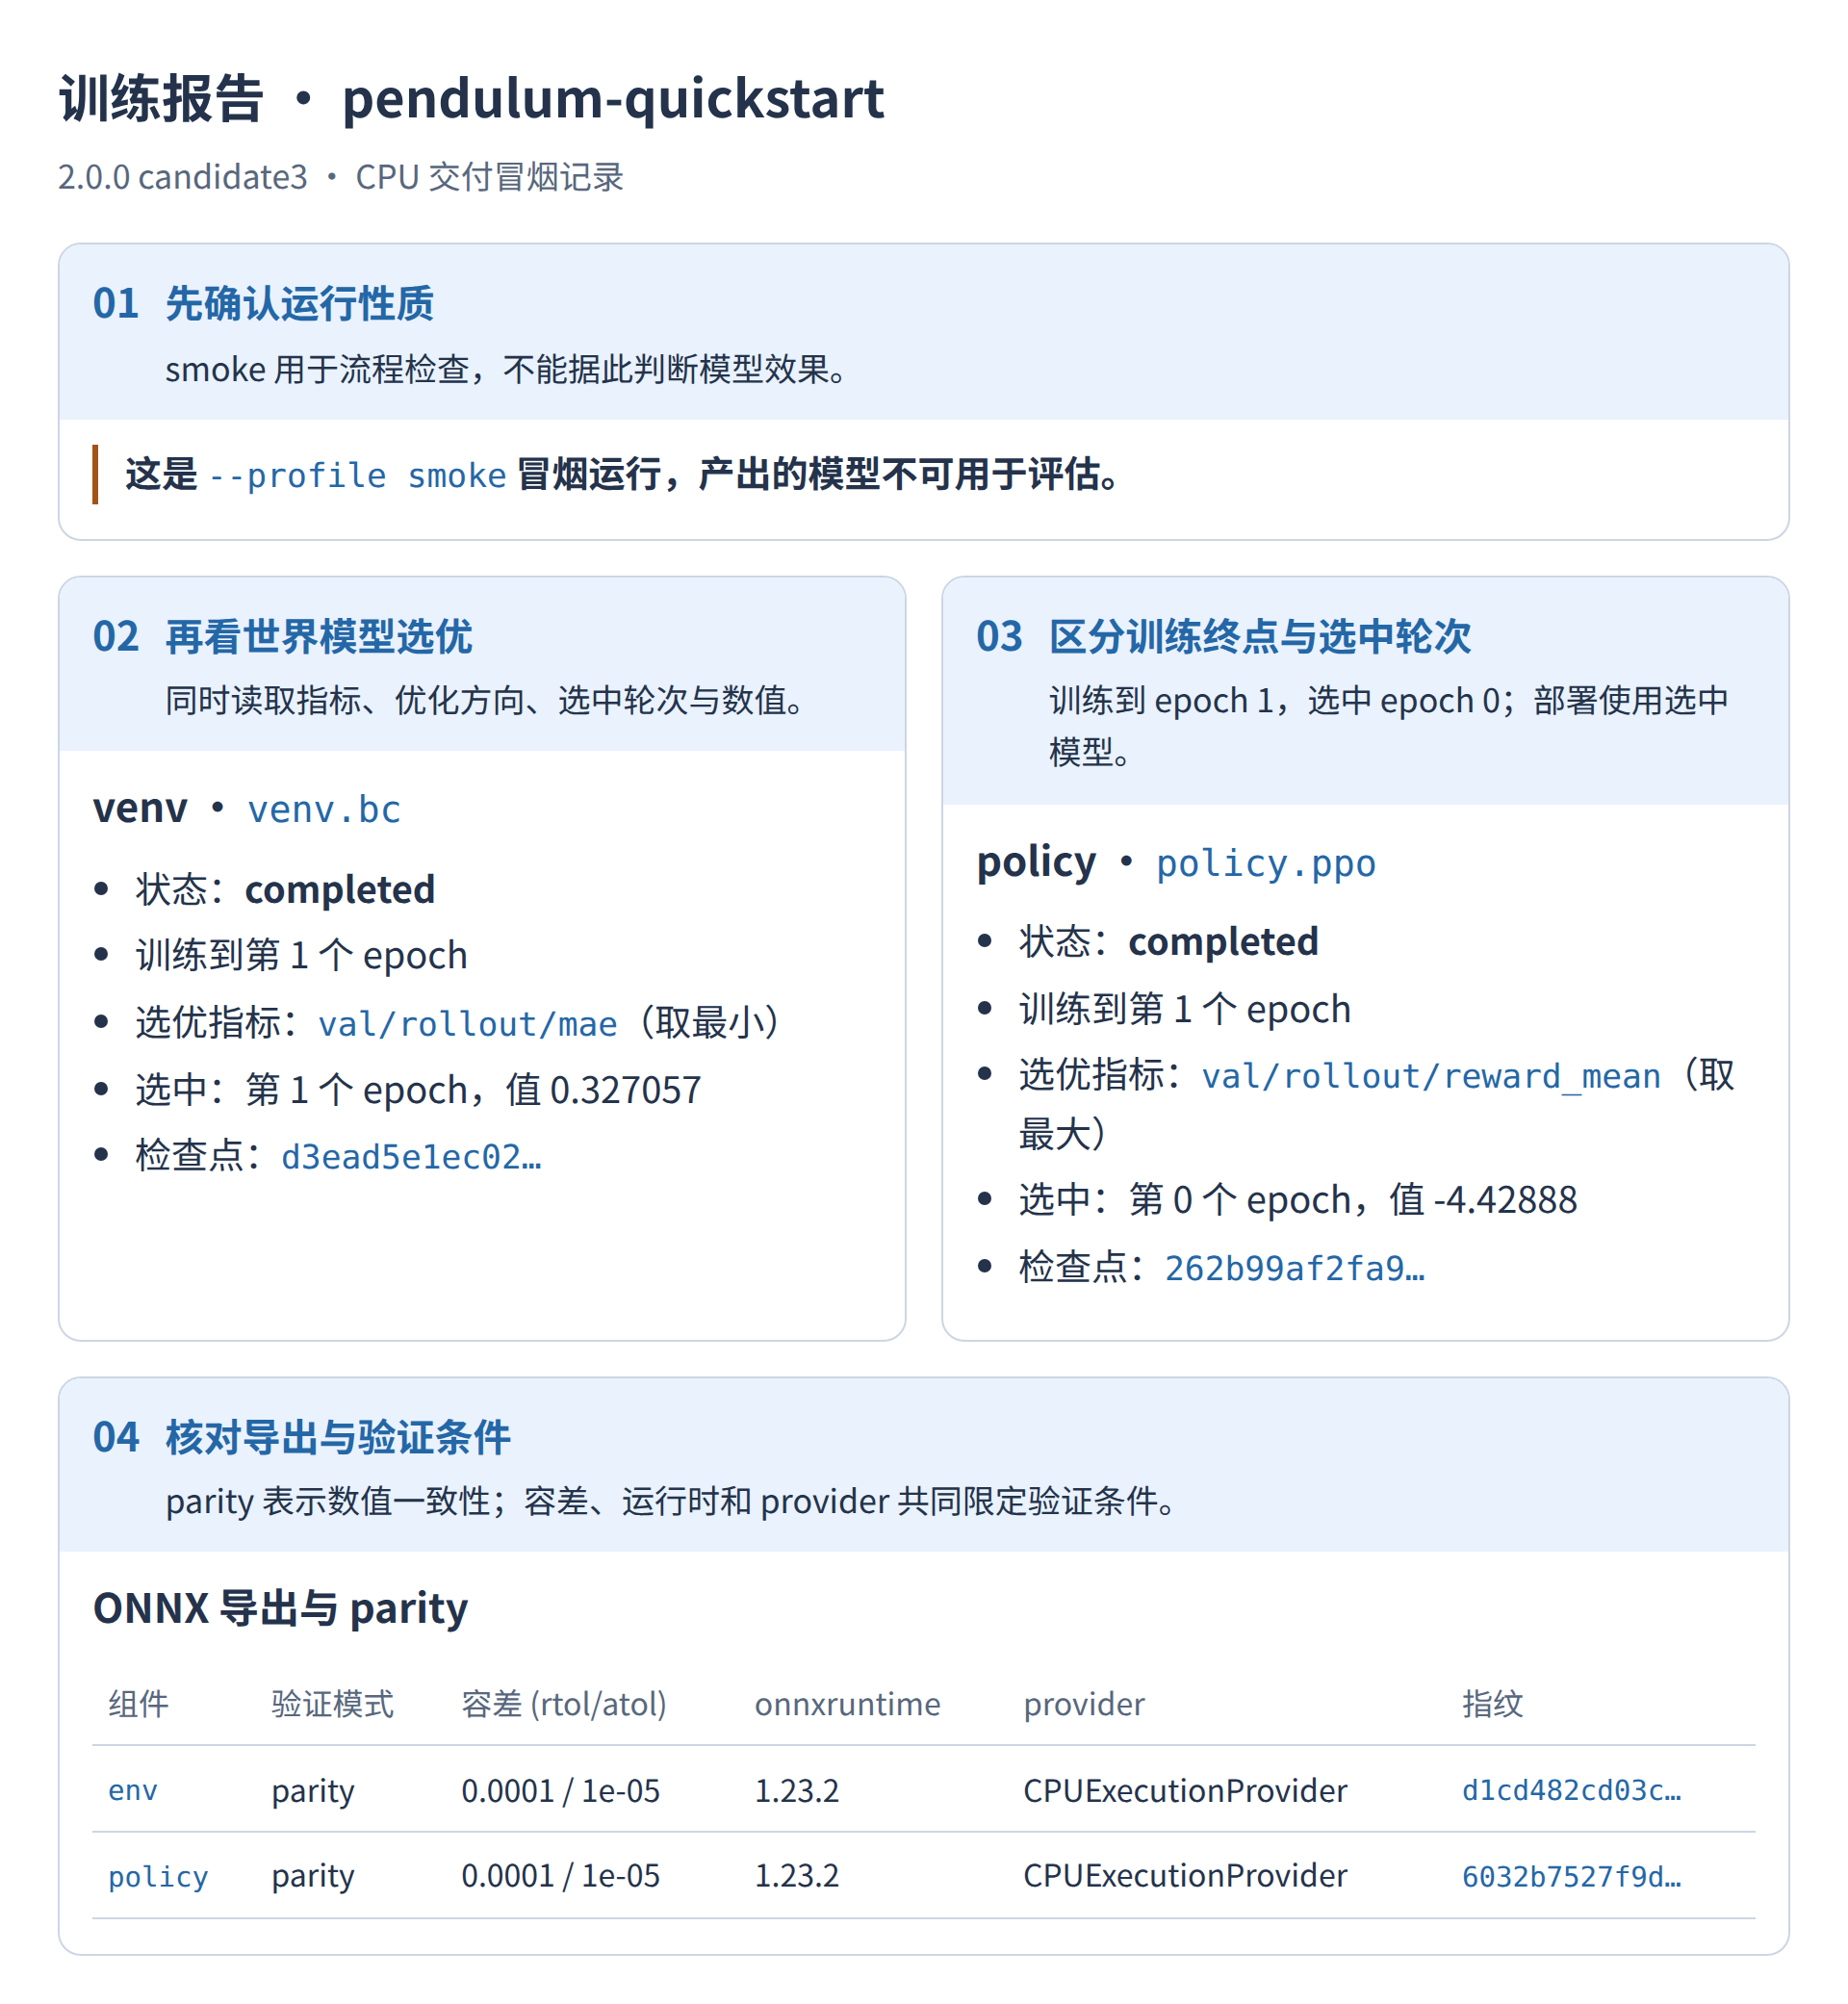
图:训练报告的主要字段位置。
图中的短训练记录用于说明字段位置。阅读自己的报告时,以实际选中模型的指标分析效果。completed 表示阶段完成;误差和收益是否达到目标,还需按下面的业务指标判断。
通常从 models/env.pt、models/policy.pt 读取运行级选中模型,各阶段的详细记录位于 venv/<阶段名>/ 和 policy/<阶段名>/。多阶段训练可能选中较早阶段的模型,最后一轮也未必是最佳轮次。完整文件说明见使用与部署模型。
判断世界模型效果
同时查看单步与多步预测
单步预测回答“下一周期能否预测准确”,多步推演回答“连续预测是否逐渐偏离”。倒立摆可以检查角度、角速度的变化,冰箱温控则重点检查制冷、停机和开门后的温度曲线。
| 结果 | 需要关注的现象 | 下一步 |
|---|---|---|
| 单步 MAE、RMSE | 温度误差多少 ℃、角速度误差多少 rad/s | 核对业务能够接受的误差范围 |
| 多步误差曲线 | 随步数增长的漂移、振幅和响应延迟 | 判断计划使用的预测时间范围是否可用 |
| 各节点和工况的误差 | 总体较好但某个关键量或启停工况较差 | 单独分析该节点或补充工况数据 |
| 预测与实测曲线 | 转折、超调、恢复速度是否一致 | 检查驱动变量、历史信息与采样对齐 |
例如冰箱模型的平均温度误差较小,但开门后持续低估温升,仍会影响制冷策略。应单独查看开门片段,确认模型是否使用了正确的门状态,以及训练数据是否覆盖这种扰动。
启用绘图并成功恢复选中世界模型后,阶段目录下的 model_health.json 提供原始单位的误差、逐步 MAE 和最差绘图样本序号;类别与有序离散量还可查看相应分类或秩误差。这里的样本诊断帮助定位问题,选模结论仍以配置的验证指标为准。
结合数据覆盖定位偏差
revive validate --config config.yaml --data-health数据体检检查非有限值、常量列、范围、类别取值、离散网格和轨迹结构。报告中的训练/验证覆盖差异可以帮助解释误差,例如高温工况只在验证集出现,或某种运行模式在训练集中没有样本。
采样周期、单位、动作延迟和工况含义还需要结合业务核对。数据中的取值范围代表历史覆盖,动作物理边界应按设备能力设置。归一化及数据划分说明见设置训练数据。
报告中的相邻实测值基线使用上一时刻真实值;自主多步推演中的保持状态基线则持续使用预测起点的状态。比较模型与基线时,应先确认它们使用了相同的输入条件。
判断控制策略效果
将奖励对应到业务目标
| 指标 | 如何理解 |
|---|---|
reward_mean | 每条轨迹先对有效步的奖励求均值,再对轨迹平均 |
return_mean | 每条轨迹的未折扣累计回报,再对轨迹平均 |
| 目标跟踪指标 | 温度、液位、距离或姿态偏差是否满足业务目标 |
| 动作与约束指标 | 能耗、动作变化、边界使用及约束违反是否可接受 |
若一条轨迹的逐步奖励为 [1, 2, 3],平均奖励为 2,累计回报为 6。回报出现负值并不代表计算错误,例如温度偏差和能耗都作为惩罚时,接近 0 可能比更负的值好。指标方向要与实际奖励定义一致。
冰箱温控应同时查看温度偏差、制冷动作及能耗代价;倒立摆应同时查看直立保持情况、力矩大小与动作变化。改变奖励尺度或推演长度后,原始分数需要在统一条件下重新比较。
检查动作与闭环表现
策略在世界模型中获得高奖励后,还应查看动作是否持续饱和、频繁跳变或进入训练数据缺少覆盖的区域。使用任务提供的独立仿真或业务评估程序,与现有控制方案比较。
policy.bc 可以作为学习历史动作的基线,但它自身有拟合误差。比较时同时保留历史操作或现有控制器的表现,观察主要工况下的收益与约束。
阅读不确定性信号
启用不确定性评估时,可结合输入偏离、误差风险和预测区间解释异常工况。accepted 表示相关信号满足其验收要求;世界模型精度、控制收益和 ONNX 数值一致性仍各自检查。指标读法见不确定性结果说明。
比较不同实验
固定评价条件
比较学习率、算法或历史窗口之前,保持数据划分、关键节点、单位、奖励定义、评估长度和初始条件一致。使用不同配置训练后,比较各自选中模型,并记录训练与推理开销。
| 比较项目 | 建议记录 |
|---|---|
| 模型效果 | 单步和多步误差,或业务回报与关键约束 |
| 数据与工况 | 数据版本、轨迹划分、初始状态、主要工况覆盖 |
| 模型与配置 | run ID、选中阶段与轮次、参数改动 |
| 稳定性 | 相同一组训练种子下的结果及波动 |
| 开销 | 训练时间、资源占用、目标设备上的推理延迟 |
timing.json 可帮助定位训练或验证耗时;它记录主机侧时间,不能代替部署端单步延迟测量。参数对比的具体步骤见比较实验结果。
使用独立测试数据
训练集用于更新模型,验证集用于选择模型和参数。方案确定后,用预留测试数据或独立仿真评价最终效果。当前归一化统计会使用训练与验证数据,因此最终测试数据应留在训练准备流程之外。
--val-data 指定验证数据,最终测试由任务评估程序或业务流程执行。如果根据测试结果继续调参,后续最终评价还需准备未参与选择的数据。独立数据的具体组织方式见评估与选择模型。
完成业务验收
按工况检查目标
先确认预测误差或控制收益,再检查接入后的业务表现。ONNX parity 说明同一输入下导出模型与原模型数值一致;部署效果还取决于真实输入、控制周期和执行设备。
温控任务可以分为稳定运行、启停和开门扰动,车辆跟随可以分为匀速、加减速和前车制动。分别检查后再汇总,避免平均结果掩盖关键工况。
保存验收结论
| 项目 | 应记录什么 |
|---|---|
| 业务目标 | 被控量、收益或成本、统计周期 |
| 比较基线 | 现有方案及相同的运行条件 |
| 数据与模型 | 数据来源、划分、模型版本、配置和选中模型 |
| 评价标准 | 指标、单位、方向、预先约定的目标值 |
| 实际结果 | 各工况结果、样本数、约束表现与适用范围 |
| 结论 | 是否达到目标,以及需要补充验证的条件 |
保存报告、配置、选中模型、依赖与评估结果,便于后续交接和复查。进入使用与部署模型接入业务系统;需要继续训练或整理运行记录时,查看管理训练任务。