
水处理
本例以水处理中的加氯过程为对象,使用运行数据训练世界模型,在模型中搜索 PID/FFPID 参数,并通过全年仿真评估出口余氯稳定性与药耗。
1. 任务背景与目标
从投药到出口余氯的业务过程
水处理中的加氯环节通过投加药液维持消毒后的余氯。本例聚焦出口余氯控制:既要避免浓度不足,又要避免过量投药,并观察偏离目标持续了多长时间。以下浓度区间是本仿真案例的控制目标。
控制链条包含四个时间尺度。投加命令先经过执行器惯性和变化速率限制,形成实际药液流量;药液再经过输送和混合影响池内浓度;进出水、温度及耗氯过程改变出口浓度;最后仪表经过滤波并叠加测量误差,给出控制器能读取的数值。增加当前命令不会立刻得到相同幅度的出口响应。
进水流量增加时,同一投加量会被更多水稀释;流量和水位还会改变停留时间。因而数据需要同时记录投加命令、实际投加、流量、水位、温度与余氯。物理余氯与仪表读数必须区分:前者用于本例的模型监督和效果评价,后者才是控制器的反馈信号。
控制目标与工艺关系
本案例的目标是使出口物理余氯长期稳定在 0.9 mg/L 附近,减少过高或过低的情况:
| 出口物理余氯 mg/L | 业务含义 |
|---|---|
| 0.9 | 目标值 |
| [0.8, 1.0] | 正常 |
| [0.7, 0.8)、(1.0, 1.1] | 严重告警,尽量减少占比和持续时间 |
| <0.7 或 >1.1 | 生产事故 |
三类互斥,按未四舍五入的每分钟值判定。0.7 与 1.1 本身属于告警,不是事故。
图:工艺与反馈关系示意。物理余氯标签用于训练和评价,部署控制器读取仪表值与当前遥测。
数据来自受约束的控制过程,动作范围较窄,世界模型在数据外动作下的预测需要额外验证。因此,策略筛选依次检查多模型一致性、长时控制效果和初态扰动响应,再通过独立仿真评价选中策略。
2. 数据与准备
过程有输送和仪表延迟,不能只用一行当前读数代表完整状态。数据包按分钟对齐命令、遥测和状态,并为每个预测窗口保留 6 小时可见历史,用于初始化执行器、混合过程和仪表记忆。
来源与获取
原始数据是一条 seasonal_year 仿真轨迹,约 365 天、525,600 个分钟记录。本例使用由该轨迹整理的 train/dev 窗口包,封存的 temporal_test 不参与训练或选策。
取得获授权的分钟级示例数据包,解压到以下位置;详见examples/chlorination/data/README.md:
examples/chlorination/data/offline/
├── manifest.json     数据版本、字段、时间对齐与内容哈希
├── train.npz         340个历史窗口
└── dev.npz           71个后续窗口
已经持有本任务的兼容对齐包时,可以制作可移植副本。这只核验和复制现有文件,不调用仿真采集:
python -m examples.chlorination.tutorial package-data \
  --source-dir /path/to/authorized/aligned_dataset \
  --data-dir examples/chlorination/data/offline
source-dir 需要包含兼容的 manifest、train.npz 和 dev.npz,并提供分钟级物理标签。准备数据时按下表核对字段与采样周期;导入命令要求目标目录尚不存在。
字段、单位与时间对齐
| NPZ 字段 | 每帧维度 | 含义 |
|---|---|---|
| action_cmd | 1 | 归一化 specific-dose 命令[0,1],不是实际 L/h |
| exogenous | 4 | 进水流量 m³/h、出水流量 m³/h、水位 m、温度°C |
| plant_state | 5 | 实际投加量 L/h、池内物理余氯、出口物理余氯、池内仪表、出口仪表;余氯单位 mg/L |
| observation | 5 | 投加遥测与仪表代理,不把物理真值作为控制器观测 |
| observed_mask | 1 | 前 360 分钟为可见历史,后续为 0 |
| source_step / source_traj_id | 各 1 | 原始分钟和轨迹索引,用于对齐、去重、时间隔离 |
| index | 每窗口 1 个 | 每个窗口末端的 exclusive 累计索引 |
每个训练窗口 1081 帧:360 分钟历史+720 分钟预测+末端状态。observation后续部分保持最后历史读数并标记不可见;监督目标仍来自plant_state。不能将未来仪表当已知输入。
原日志中obs[t]、command[t]在执行前,info[t]在执行后,因此plant[t]使用前一条物理记录。当前包已完成对齐,不要再次偏移。
物理余氯是过程浓度,仪表余氯是包含测量动态与误差的读数。**当前物理标签用于世界模型训练和评价,控制器部署不读这些标签。**自有数据只有仪表时,需要另行设计观测模型与物理目标验证,需要为不可直接测量的物理量建立可核验的标定依据。
按时间隔离不同用途
prepare将原 train 按完整窗口跨度约 60%/20%/20%拆分;不随机打散重叠窗口。
| 数据 | 当前窗口数 | 用途 |
|---|---|---|
| fit | 203 | 训练世界模型、拟合初始化统计量和前馈 |
| validation | 67 | 挑选世界模型 checkpoint |
| selection | 68 | 搜索和排序策略参数 |
| dev | 71 | 唯一候选冻结后验证,不换冠军 |
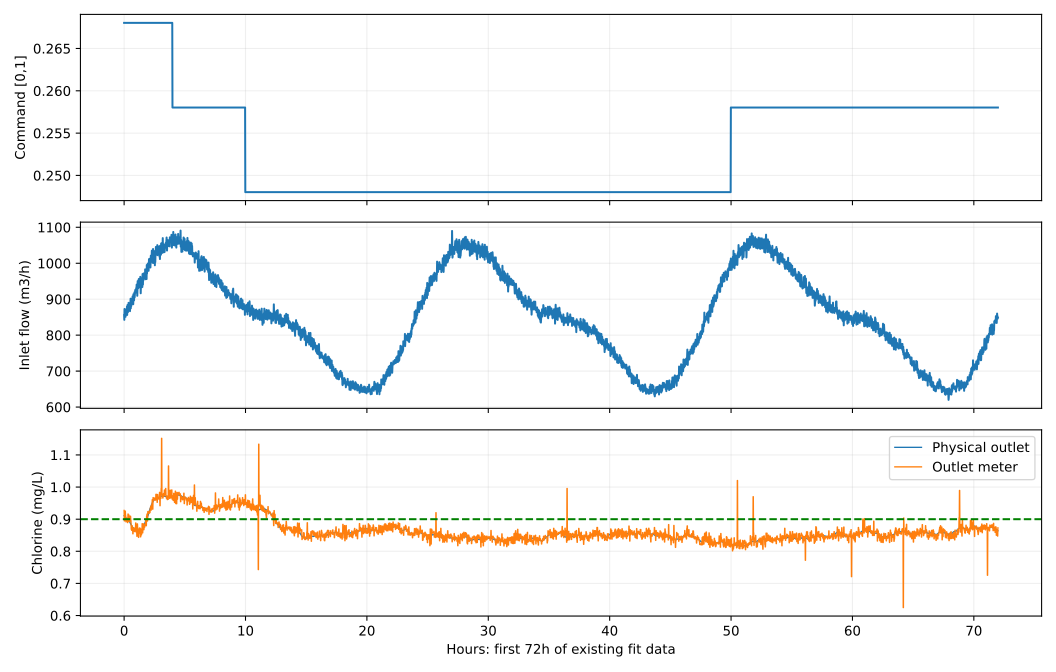
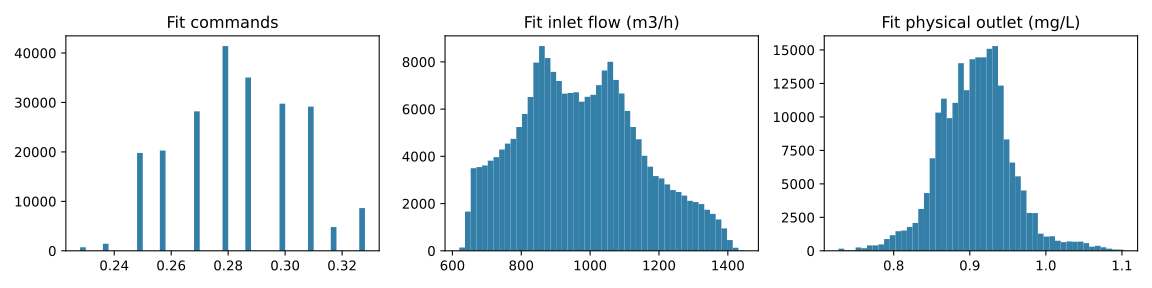
两个跨界原 train 窗口不使用。控制评估从 selection/dev 连续记录中按时间抽取 12 个未来不重叠的 72 小时窗口,不根据结果挑窗。dev 用于开发验证。报告会展示历史 72 小时曲线和 fit 分布,帮助理解动作窄分布和仪表偏差。
先观察 fit 数据的时序变化和变量分布:
数据检查与预处理
以下命令均在仓库根目录运行,每次使用独立的 run 目录:
python -m examples.chlorination.tutorial prepare \
  --data-dir examples/chlorination/data/offline \
  --root examples/chlorination/logs/my_chlorination \
  --device cuda:0
无 CUDA 时用--device cpu,训练/导出可能更慢。examples/chlorination/configs/tutorial.yaml固定 训练与评估规模,设备在 prepare 时写入。生成manifest.json、calibration.json、data/{fit,validation,selection,dev}.npz及recipes/{s42,s43,s44}.yaml。
3. 建模与配置
先看 examples/chlorination/configs/tutorial.yaml。它定义整个任务的训练、候选搜索和评估流程,由 tutorial prepare 读取;准备步骤会进一步生成可交给 REVIVE 的模型训练配置。
version: chlorination.tutorial.v1
training:
  seeds: [42, 43, 44]
  epochs_per_model: 20
offline:
  candidates: 48
  shortlist: 6
  windows: 12
  warmup_minutes: 360
  horizon_minutes: 4320
  initial_shifts: [-0.03, 0.03]
  prediction_budget: 12000000
  warmup_budget: 1200000
objective:
  physical_target: 0.9
  normal: [0.8, 1.0]
  accident_outside: [0.7, 1.1]
  warning_weight: 20.0
  ranking: mean + 0.5*std + 0.25*worst_block
  max_action_delta_5min: 0.002
reference:
  scenario: seasonal_year
  seeds: [1000, 2000]
  days: 364
  physics_budget: 2100240
  reset_budget: 2
  replay_of_previously_seen_seeds: true
配置入口
| 配置 | 用途 |
|---|---|
examples/chlorination/configs/tutorial.yaml | 世界模型数量、搜索条件、余氯目标与年度评估设置 |
recipes/s42.yaml | prepare 生成的模型训练配置;其余种子使用同一模型结构 |
已知机制与需要学习的过程
动作是归一化投加命令。先依据进水流量换算目标药液流量:
d_target = clip(command × d_max × q_in / q_reference, 0, d_max)执行器的惯性、变化速率和死区由 examples/chlorination/control_ready/known_equipment.json 描述。把这些已知机制写入模型,可以让学习集中在作用增益、输送、混合、耗氯及仪表响应上。
决策流图
生成的模型配置采用以下状态更新结构:
graph:
  warmup_depth: 360
  nodes:
    delta_plant_state:
      inputs: [action_cmd, exogenous, observation, observed_mask, plant_state]
      warmup_inputs: [action_cmd, exogenous, observation, observed_mask, plant_state]
      network:
        backbone: known_positive_process
      output_dist: deterministic
    next_plant_state:
      inputs: [plant_state, delta_plant_state]
      function: builtin.delta_add
  transitions:
    plant_state: next_plant_state
这一段展示图结构;完整的列定义和网络参数由 prepare 根据设备参数与 fit 数据生成。plant_state 同时描述实际投加、物理余氯和仪表状态。前 360 分钟的观测用于初始化过程记忆,后续预测由模型状态递推。
配置逐块讲解
| 配置块 | 业务含义与设置 |
|---|---|
training | seeds 42、43、44 分别训练一个世界模型,每模型 20 epoch;多模型用于检查候选对预测差异的敏感度 |
offline | 搜索 48 个候选,在 12 个 72 小时窗口中评估;每窗先暖机 360 分钟,前 6 名再接受 ±0.03 mg/L 初态扰动 |
objective | 以物理余氯 0.9 mg/L 为目标,正常范围为 [0.8, 1.0],事故边界为 [0.7, 1.1];每 5 分钟的命令变化不超过 0.002 |
objective.ranking | 综合平均成本、条件间波动与最差时间块,减少只在某一个模型或时段表现好的候选 |
reference | 使用两个 seasonal_year 场景,每策略连续评估 364 天;在同一完整初态和外部扰动下比较控制效果 |
生成配置的 graph | 使用已知执行器机制与可学习过程模型,builtin.delta_add 合成下一状态 |
生成配置的 data | batch_size 16,显式读取 fit 与 validation 文件;按完整窗口保留时间关系 |
生成配置的 training | 使用 venv.bc,学习率 0.001、梯度裁剪 1.0;每段监督预测长度为 720 分钟 |
生成配置的 validation | 每 2 epoch 及末轮检查多步误差,按 val/rollout/primary_nmae 最小值选模;物理出口和仪表出口权重为 0.7/0.3 |
生成配置的 output | 保存模型、训练状态和指标,并完成 ONNX 导出与一致性校验 |
720 分钟用于世界模型训练,4320 分钟用于策略效果评估,5 分钟是控制决策间隔。分别设置这些尺度,是为了同时覆盖短期动态、长期浓度稳定性和设备实际控制频率。
生成配置中的 training.stages[venv].hyperparameters.sequence_train 控制连续 720 分钟的递推训练;其中 training.stages[venv].hyperparameters.sequence_train.objective 对物理出口和仪表出口分别加权。training.stages[venv].validation 在验证窗口上采用相同的通道权重,使训练目标与选模指标对应。
4. 训练与选模
世界模型训练
python -m examples.chlorination.tutorial train \
--root examples/chlorination/logs/my_chlorination入口实际调用标准revive train。seed42、43、44 三模型各训练 20 epoch,共 60 epoch;输入为 prepare 生成的 fit 与 validation 数据。
单模型内部调用形式如下,供理解;用教程入口后不要重复执行:
revive train \
  --config examples/chlorination/logs/my_chlorination/recipes/s42.yaml \
  --train-data examples/chlorination/logs/my_chlorination/data/fit.npz \
  --val-data examples/chlorination/logs/my_chlorination/data/validation.npz \
  --log-dir examples/chlorination/logs/my_chlorination/models \
  --run-id s42 --seed 42
查看 logs/my_chlorination/models/ 中各模型的报告、最佳模型与 ONNX 校验结果。model_freeze.json 记录用于后续搜索的模型,后续步骤从该文件读取。
训练损失衡量预测质量,物理与仪表通道的多步误差用于判断模型是否适合后续筛选。策略控制收益通过第 5 节的独立仿真评估检验。
策略构建与筛选
控制目标与排序
令e = |出口物理余氯 - 0.9|,使用独立业务成本,越小越好:
tracking_cost = (e / 0.1)^2
warning_cost = (max(e - 0.1, 0) / 0.1)^2
condition_cost = mean(tracking_cost + 20 × warning_cost)
ranking_score = 条件均值 + 0.5 × 条件标准差 + 0.25 × 最差时间块成本
先剔除存在事故或非法执行的候选,再按连续分数排序。排序目标使用物理余氯偏差与告警成本。
搜参、初态压力与冻结
python -m examples.chlorination.tutorial search \
--root examples/chlorination/logs/my_chlorination此步骤完全离线,只在学习世界模型中推演:
- 生成 48 组 PID/FFPID 候选,包括比例、积分、微分、偏置和前馈组合。
- 每个候选在 3 个模型、12 个 72 小时窗口中闭环评估。
- 前 6 名用 seed42 模型补充正负初态扰动。
- 汇总正常和压力条件,冻结至多一个候选。
- 对被冻结者做 dev 五条件验证,不据 dev 结果换第二名。
初态扰动在起点将池内和出口的物理余氯估计同时加、减 0.03 mg/L,保持仪表、历史与 PID 初始化不变。偏差仅在起点施加一次,用于观察策略对初始状态误差的敏感度。
FFPID 的前馈只拟合 fit 段记录下来的动作,不读取原专家函数。这里说的“策略构建”准确讲是世界模型训练加上 PID/FFPID 离线搜参,而不是训练一个 PPO 网络——两者的产出和可解释性都不一样。最终选出哪一组以policy_freeze.json为准,换数据或换种子后未必还是 PID_07。
当前 48 组由下表的笛卡尔积组成,不是手工指定最终参数:
| 搜索维度 | 候选值 |
|---|---|
| 结构 | PID、FFPID |
| 仪表偏差修正 bias | 0、fit 数据得到的校正值 |
| 比例系数 kp | 0.15、0.5、1.0 |
| 积分系数 ki | 0.005、0.02 |
| 微分系数 kd | 0、0.1 |
PID 误差来自滤波仪表加 bias 与 0.9 的差,不读取实时物理真值。积分和导数按小时计时,不能将这里的系数直接填入时间单位不同的设备 PID。滤波 15 分钟、死区 0.01 mg/L、抗积分饱和 0.5 小时是本配置方案固定项。
HOLD 保持交接动作,LOGGED 在学习模型中回放已记录的动作,两者用于诊断模型响应。专家与新策略的闭环对照在独立仿真中完成。
5. 模型使用与评估
导出与策略调用
候选通过离线 dev 后,导出可移植参数文件:
from pathlib import Path
from examples.chlorination.tutorial.deploy import export_policy, load_policy

run = Path("examples/chlorination/logs/my_chlorination")
export_policy(run)
controller = load_policy(run / "deployment/policy.json")

# 以下变量由设备遥测提供,不是未来数据或物理真值:
# last_command: [batch]
# outlet_meter_history: [batch, 361],每分钟一条
# exogenous_now: [batch, 4],进/出水流量、水位、温度
controller.reset(last_command, outlet_meter_history, exogenous_now)
action = controller.act(exogenous_now)  # 每5分钟一次,首次保持交接动作
controller.observe(outlet_meter_now)    # 每分钟末调用,形状[batch]
snapshot = controller.snapshot()
controller.restore(snapshot)上面是接口示意,遥测变量需要由调用方提供,完整的持续调用见examples/chlorination/tutorial/evaluation.py。接入时有两点特别容易出错,请留意:EMA、积分、导数和上次动作都属于状态,必须跨调用保持,每 5 分钟重新初始化会让积分项永远归零;命令本身已经归一化,再乘一次流量就成了重复计流量。部署阶段不需要世界模型,也不需要原专家。
当前权限使用 fit 动作范围,5 分钟动作变化≤0.002,包含无跳变接管与反算抗积分饱和。fit 范围不是设备硬件边界的同义词。
独立仿真评估
只有候选冻结且完成 dev 后,才显式执行:
python -m examples.chlorination.tutorial evaluate \
  --root examples/chlorination/logs/my_chlorination \
--simulator-root /path/to/indusim_source该目录下应有indusim/包,已经安装可导入的 indusim 时可省略参数。仿真器是独立可选依赖,需从获授权渠道取得;离线训练/搜索不需要安装它。
| 对照要素 | 做法 |
|---|---|
| 场景和时长 | seasonal_year;seed1000、2000,每策略各连续 364 天,不按天 reset |
| 初态 | reset 内 24 小时暖机,再 6 小时专家暖机;同一完整状态分支 |
| 原专家 | 仅验收可用;120 分钟巡检换算为 24 个 5 分钟调用,延续暖机记忆 |
| 候选 | 使用实际冻结参数和权限,不改参或换冠军 |
| 反馈 | 两分支分别读取自己的仪表;控制器不读物理真值 |
| 配对核查 | RNG、扰动、执行器、输送和仪表完整初态;外生路径逐分钟一致 |
| 仿真规模 | 含全部暖机共 2,100,240 个底层物理分钟步;reset 2 次 |
| 保存 | 每 28 天保存分钟曲线和完整环境/控制器状态 |
余氯控制与水力条件分别评价:余氯事故影响余氯控制验收,水位越界作为外生水力条件单独记录,并影响整体上线判断。测试结果用于评估已经选定的候选。
6. 结果与分析
生成训练、离线筛选和独立仿真的综合报告:
python -m examples.chlorination.tutorial report \
  --root examples/chlorination/logs/my_chlorination \
  --output examples/chlorination/reports/my_chlorination
报告读取已保存的结果,不重新推进仿真。打开输出目录中的 report.md 查看指标、年度曲线和固定最后一周的曲线;再次生成时使用新的输出目录。
模型与策略筛选
三个世界模型各训练 20 epoch。48 组 PID/FFPID 候选经过多模型评估与初态压力验证,选中 PID_07:kp=0.5、ki=0.02、kd=0.1、bias=0。控制器读取仪表和当前遥测,目标为出口物理余氯 0.9 mg/L。
| dev 模型条件 | 预测物理 MAE(mg/L) | 告警占比 | 事故分钟 |
|---|---|---|---|
| s42 | 0.01965 | 0.000% | 0 |
| s43 | 0.01982 | 0.112% | 0 |
| s44 | 0.02167 | 0.000% | 0 |
| 初态偏移 −0.03 mg/L | 0.01989 | 0.747% | 0 |
| 初态偏移 +0.03 mg/L | 0.01985 | 0.000% | 0 |
这些是模型内的预测指标,用于检查选中候选对模型差异和初态误差的敏感度。控制收益由下面的独立仿真评价。
年度控制效果
每个 seed 下,专家与 PID_07 从相同完整初态分支,分别连续运行 364 天。
| seed | 策略 | 物理 MAE(mg/L) | 正常占比 | 告警占比 | 事故分钟 | 药耗(L) | 最长告警(min) |
|---|---|---|---|---|---|---|---|
| 1000 | 专家 | 0.04405 | 95.646% | 4.352% | 9 | 113385.61 | 889 |
| 1000 | PID_07 | 0.03246 | 98.142% | 1.858% | 0 | 115738.88 | 827 |
| 2000 | 专家 | 0.05498 | 88.304% | 11.653% | 223 | 109868.61 | 2720 |
| 2000 | PID_07 | 0.03801 | 97.452% | 2.548% | 0 | 113472.27 | 692 |
两 seed 平均物理 MAE 从 0.04951 降至 0.03523 mg/L,下降 28.84%;告警减少 72.47%,药耗增加 2.67%。28 天区组配对 MAE 差的 95% 区间为 [-0.01775, -0.01138] mg/L,描述这些仿真轨迹内不同时段的差异。
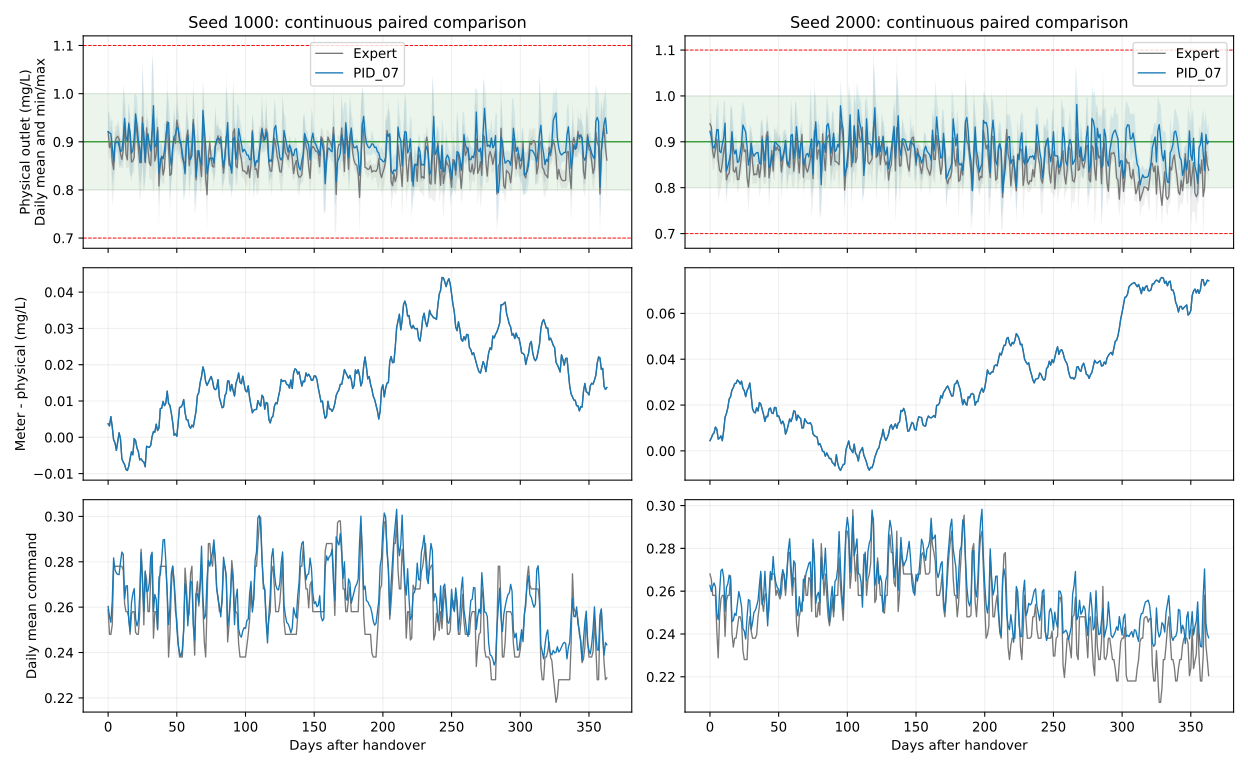
第一行显示每日物理余氯均值及日内最小/最大范围,第二行显示仪表与物理浓度的日均偏差,第三行显示日均命令。事故与告警时长按分钟数据计算,日均图用于观察趋势。
水力条件与业务判断
PID_07 在这两条轨迹中没有余氯事故,但最长连续告警仍有 827 和 692 分钟,应结合业务允许的持续时间评估。seed 2000 中两种策略都出现 544 分钟低水位;水位由进出水决定,投氯控制器没有调节水位的权限。
本案例的余氯控制验收通过,整体上线放行为否。水位越界时仿真会钳制水位并跳过质量积分,这些时段需要单独检查。迁移时应分别设置余氯控制、药耗和水力运行条件的验收指标。
7. 迁移到实际业务
迁移时先明确处理工艺、目标物理量和可获得的仪表信号,再确定世界模型与控制策略的边界。本例聚焦加氯余氯控制;其他水处理环节需要各自的数据、机制和评价指标。
目录与运行条件
chlorination/
├── README.md                用户教程
├── configs/tutorial.yaml    完整训练与评估规模
├── tutorial/                用户CLI、数据、训练、部署、仿真和报告
├── offline_policy/          已验证的搜索与控制器实现
├── data/offline/            获授权本地数据包,不提交源码
├── logs/<run>/              训练、筛选、部署包与reference验收产物
└── reports/<run>/ 自动报告和图表| 阶段 | 运行额度 | 外部仿真 |
|---|---|---|
| 训练 | 3×20 epoch;当前数据 780 次优化更新 | 否 |
| 搜索/压力/dev | 最多 1200 万模型预测分钟、120 万模型暖机分钟 | 否 |
| 年度对照 | 含暖机 2,100,240 个物理分钟步 | 仅显式 evaluate |
| 报告 | 只读保存结果 | 否 |
准备预检失败保留审计,不创建训练运行额度;修正输入后可产生新预检记录。正式训练或验收开始后不自动覆盖或重置运行额度,完整状态保留供明确恢复。没有合格候选时停在离线阶段,不构造仿真环境。
迁移到自有任务时重新核实设备机制、标签/观测可用性、控制周期、延迟、数据范围和独立验收条件,并根据实际条件调整 PID_07 的配置。
阅读任务页约定,区分数据准备、训练验证和独立评估。